
How We Work · 수행 원칙
평가 문항으로 품질을 관리합니다
AI 시스템은 모델이나 프롬프트를 조금만 바꿔도 결과가 달라집니다. INSTEP은 구축 단계에서 평가 문항을 함께 만들고, 변경할 때마다 같은 문항으로 다시 검증합니다.
성공 기준 먼저
대상 업무의 처리 시간, 정확도, 사람 검토 비율을 착수 전에 정합니다.
사람이 승인하는 단계
발송, 결제, 삭제처럼 되돌리기 어려운 작업은 사람이 확인한 뒤 실행하도록 설계합니다.
변경마다 재검증
모델, 프롬프트, 도구 설정을 바꿀 때마다 같은 평가 문항으로 결과를 다시 확인합니다.
Service 01 · Custom Agents
맞춤형 AI 에이전트·업무 자동화
반복 업무를 처리하는 AI 에이전트를 설계하고 사내 시스템, 문서, 메신저와 연결합니다. 에이전트가 쓰는 도구와 권한, 사람이 승인할 단계를 먼저 정합니다.
MCP(Model Context Protocol) 서버로 사내 도구를 연결하고, 처리 결과와 실패 사례를 기록해 운영 중에도 품질을 확인합니다.
진행 단계
- 대상 업무와 성공 기준 정의
- 도구·권한·승인 단계 설계
- 에이전트와 MCP 서버 구축, 사내 시스템 연동
- 평가 문항으로 품질 검증
- 시험 운영, 운영 기록 점검과 인계
산출물
- 에이전트 설계서
- 도구·권한 목록
- 에이전트와 연동 코드
- 평가 문항과 결과
- 운영 매뉴얼
Template · 산출물 견본
에이전트 설계서 양식
| 대상 업무 | 입력, 처리, 결과물과 담당 부서 |
|---|---|
| 성공 기준 | 정확도, 처리 시간, 사람 검토 비율 |
| 도구 | 조회·작성·발송 등 에이전트가 쓰는 기능과 연결 방식(MCP, API) |
| 권한 | 읽기·쓰기 범위, 개인정보 접근 제한 |
| 승인 단계 | 사람이 확인한 뒤 실행하는 작업 목록 |
| 기록 | 처리 기록, 실패 사례, 비용 집계 |
실제 설계서는 업무 담당자 인터뷰와 시험 데이터를 바탕으로 작성합니다.
업계 공개 자료 기준
Industry Benchmarks · Public Data| 지표 | 수치 | 기준과 출처 |
|---|---|---|
| 생성형 AI 도입 후 고객지원 상담원 시간당 해결 건수 | +14% | NBER Working Paper 31161, 상담원 5,179명 데이터 NBER (Brynjolfsson 외) · 확인 2026-11-06 |
| 저숙련 근로자의 생산성 개선 | +34% (숙련자는 영향 미미) | NBER Working Paper 31161, 상담원 5,179명 NBER (Brynjolfsson 외) · 확인 2026-11-06 |
Measurement · 측정
도입 전 업무의 건당 처리 시간과 오류율을 측정하고, 에이전트 도입 뒤 같은 업무를 같은 기준으로 다시 잽니다.
Improvement · 개선
실패 사례를 평가 문항에 추가하고, 프롬프트나 모델을 바꿀 때마다 같은 문항으로 다시 검증합니다.
Service 02 · Document Search · RAG
AI 챗봇·사내 문서 검색(RAG)
사내 규정, 매뉴얼, 상품 자료를 검색해 근거와 함께 답하는 AI 챗봇을 구축합니다. 답변마다 참고한 문서 위치를 표시합니다.
문서 권한에 따라 답변 범위를 나누고, 자주 틀리는 질문을 평가 문항으로 묶어 정확도를 관리합니다.
진행 단계
- 대상 문서 범위와 권한 정리
- 문서 정제, 분할, 임베딩 색인 구축
- 검색·답변 흐름과 근거 표시 구현
- 질문 목록 기반 정확도 평가
- 사내 메신저·웹 연동과 운영 인계
산출물
- 문서 색인
- 챗봇(웹·메신저 연동)
- 평가 질문 목록과 결과
- 관리자 안내서
Template · 산출물 견본
RAG 구축 범위서 양식
| 문서 범위 | 대상 문서 종류, 분량, 갱신 주기 |
|---|---|
| 권한 | 부서·직급별 열람 범위 |
| 답변 방식 | 근거 문서 위치 표시, 근거가 없을 때의 안내 |
| 평가 | 실제 업무 질문 목록과 정답 기준 |
| 연동 | 웹, 사내 메신저, 기존 시스템 |
| 운영 | 문서 갱신 절차와 관리자 기능 |
업계 공개 자료 기준
Industry Benchmarks · Public Data| 지표 | 수치 | 기준과 출처 |
|---|---|---|
| GPT-4 활용 컨설턴트의 과업 처리량·속도·품질(AI 역량 범위 안 과업) | 과업 +12.2%, 속도 +25.1%, 품질 40% 이상 향상 | Harvard Business School Working Paper 24-013(2023), BCG 컨설턴트 758명 무작위 현장실험, 컨설팅 과업 18종 Harvard Business School·BCG·Wharton·MIT Sloan 공저 워킹페이퍼 · 확인 2026-11-06 |
Measurement · 측정
실제 업무 질문 목록과 정답 기준을 만들어, 답변 정확도와 근거 표시 비율을 같은 문항으로 측정합니다.
Improvement · 개선
틀린 답변은 원인(검색 실패, 문서 누락, 답변 생성 오류)으로 나눠 해당 단계를 고치고 다시 측정합니다.
Service 03 · Evaluation
LLM 평가 체계 구축
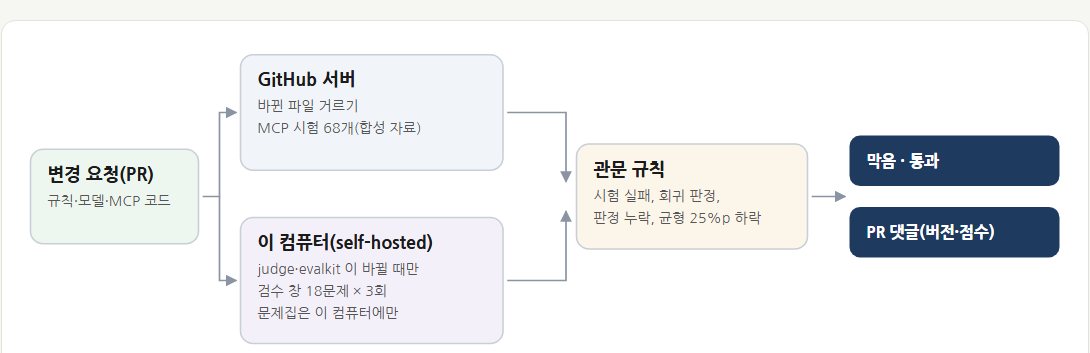
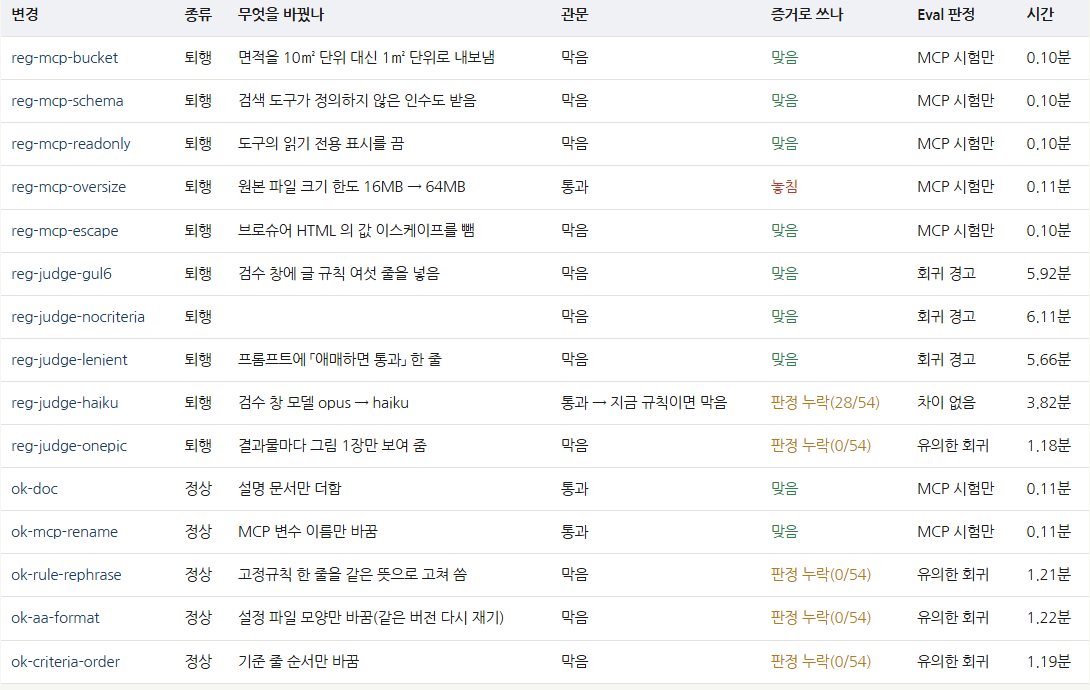
프롬프트, 모델, 도구 설정을 바꿀 때마다 같은 문항으로 결과를 다시 검증하는 평가 체계를 구축합니다. 품질이 떨어지는 변경은 배포 전에 막습니다.
평가 결과를 저장소의 변경 요청 단계에 연결해, 개발자가 결과를 확인한 뒤 반영하도록 합니다.
진행 단계
- 평가 대상 기능과 판정 기준 정의
- 평가 문항과 정답 기준 작성
- 자동 판정 실행기 구축
- 변경 요청 단계에 평가 관문 연결
- 판정 결과 보고와 문항 보강
산출물
- 평가 문항 세트
- 판정 기준서
- 평가 실행 코드
- 변경 요청 관문 설정
- 판정 결과 보고서
업계 공개 자료 기준
Industry Benchmarks · Public Data| 지표 | 수치 | 기준과 출처 |
|---|---|---|
| AI 역량 범위 밖 과업에서의 위험(주의 근거) | AI 사용군의 정답률 19%p 하락 | 위와 동일(758명) Harvard Business School·BCG·Wharton·MIT Sloan 공저 워킹페이퍼 · 확인 2026-11-06 |
Measurement · 측정
평가 문항을 고정한 상태에서 변경 전후 점수를 비교하고, 판정 결과를 변경 요청마다 기록합니다.
Improvement · 개선
운영 중 발견한 실패 사례를 문항에 추가해 같은 오류가 다시 배포되지 않게 합니다.
Service 04 · AI Training
AI 실무 교육(기업 출강)
임직원이 실제 업무에 AI 도구를 쓰도록 실습 중심 교육을 진행합니다. 부서별 업무 예시로 실습 과제를 구성합니다.
교육 후 바로 쓸 수 있는 프롬프트 모음과 업무별 사용 안내서를 함께 제공합니다.
진행 단계
- 대상 부서와 업무 사례 수집
- 과정 설계와 실습 과제 작성
- 교육 진행
- 실습 결과물 점검
- 사용 안내서와 후속 질의 응답
산출물
- 교육 과정표
- 실습 과제와 자료
- 프롬프트 모음
- 업무별 사용 안내서
Template · 산출물 견본
교육 과정표 양식
| 회차 | 주제와 시간 |
|---|---|
| 실습 과제 | 부서 업무 예시 기반 과제 |
| 도구 | 사용하는 AI 도구와 계정 준비 |
| 결과물 | 회차별로 참가자가 만드는 산출물 |
| 점검 | 실습 결과물 확인 기준 |
| 후속 지원 | 질의 응답 기간과 방식 |
업계 공개 자료 기준
Industry Benchmarks · Public Data| 지표 | 수치 | 기준과 출처 |
|---|---|---|
| 국내 생성형 AI 이용 경험자 비율 | 33.3% (2023년 17.6%) | 2024 인터넷이용실태조사, 전국 25,509가구·만 3세 이상 60,229명(2025년 3월 30일 발표) 과학기술정보통신부 조사 (이코노미스트 보도) · 확인 2026-11-06 |
| AI 코딩 도우미 사용 개발자의 과업 완료 속도 | 55.8% 빠름 | GitHub Copilot 통제 실험, 모집된 소프트웨어 개발자 arXiv 2302.06590 (Peng 외) · 확인 2026-11-06 |
Measurement · 측정
교육 전후로 같은 업무 과제를 수행하게 해 소요 시간과 결과물 품질을 비교합니다.
Improvement · 개선
참가자 질문과 막힌 지점을 기록해 다음 회차의 실습 과제와 안내서에 반영합니다.
Services · 상품과 범위
상품별 수행 범위
상품마다 기본, 표준, 종합 세 단계로 수행 범위를 나눴습니다. 금액은 범위와 일정을 확인한 뒤 견적서로 안내드립니다.
AI 챗봇·사내 문서 검색(RAG) 구축
사내 문서 기반 질의응답, 고객 응대 챗봇
- 수행 업무
- 사내 문서 100개 이내 RAG 질의응답, 웹 채팅 화면, 답변 근거 표시, 시험 질문 30개와 결과표
- 납품물
- 챗봇(배포), 구성도, 시험 결과표, 소스 코드, 설치·사용 설명서
- 기간
- 착수 후 10영업일
- 수행 업무
- 문서 500개 이내, 부서 2개 접근 구분, 문서 관리자 화면, 메신저 1종 연동, 출처 추적
- 납품물
- 챗봇, 관리자 화면, 시험 결과표, 소스 코드, 설명서
- 기간
- 착수 후 20영업일
- 수행 업무
- ERP·CRM 등 사내 시스템 연동, 다채널 응대, 사용자 인증·권한, 1개월 운영 점검
- 납품물
- 챗봇, 관리자 화면, 연동 모듈, 시험 결과표, 소스 코드, 운영 점검 보고
- 기간
- 착수 후 40일
- 보고 주기
- 운영 점검 기간 주 1회
맞춤 AI 에이전트·업무 자동화
LLM 에이전트, n8n·Make·RPA 업무 자동화
- 수행 업무
- 반복 업무 1개 n8n 워크플로 구축(외부 서비스 3개 이내 연결, 오류 알림)
- 납품물
- 워크플로 파일(JSON), 설정 문서
- 기간
- 착수 후 7영업일
- 수행 업무
- 워크플로 3~5개, 조건 분기·AI 노드(요약·분류), 실패 알림, 서버 설치, 운영 가이드
- 납품물
- 워크플로 파일, 운영 가이드, 설치 내역
- 기간
- 착수 후 14영업일
- 수행 업무
- 에이전트형 복합 워크플로(여러 단계 판단·도구 호출), 모니터링, 운영 지원 1개월
- 납품물
- 워크플로·에이전트 설정, 모니터링 화면, 운영 매뉴얼, 운영 지원 기록
- 기간
- 착수 후 25일
- 보고 주기
- 운영 지원 기간 주 1회
LLM 평가 체계 구축
AI 응답 품질 평가, 회귀 시험 장치
- 수행 업무
- 업무 1개 기준 AI 모델 응답 품질 평가: 모델 최대 3개 비교, 평가 문항 100개, 환각·지연·비용 위험 점검
- 납품물
- 평가 리포트, 평가 문항과 채점표, 개선 우선순위
- 기간
- 착수 후 7일
- 수행 업무
- 업무 2개 기준 맞춤 평가 세트(문항 300개) 구축, 판정 신뢰도 점검, 자동 회귀 시험 장치(프롬프트·모델 변경 시 자동 채점)
- 납품물
- 평가 세트, 회귀 시험 스크립트, 판정 신뢰도 보고, 결과 보고서
- 기간
- 착수 후 14일
- 수행 업무
- 표준 범위와 응답 일관성·정보 유출 점검, 운영 관측 도구 연결, 3주 시범 운영과 정확도 수치 문서화
- 납품물
- 평가 세트, 회귀 시험 장치, 관측 대시보드, 정보 유출 점검 결과, 시범 운영 보고서
- 기간
- 착수 후 21일
- 보고 주기
- 시범 운영 기간 주 1회
AI 실무 교육(기업 출강)
임직원 생성형 AI 실무 교육
- 수행 업무
- 2시간 생성형 AI 실무 특강(직무별 사례), 질의응답
- 납품물
- 강의 자료, 실습 프롬프트 모음
- 기간
- 1회
- 수행 업무
- 4시간 실습형 워크숍(문서·보고서·회의 요약·업무 자동화 실습), 1개월 메시지 질의 지원
- 납품물
- 강의 자료, 실습 과제와 예시 결과물
- 기간
- 1회와 1개월 질의 지원
- 수행 업무
- 3회 실습 과정(업무 산출물 제작, AI 직원·문의 챗봇, 브라우저 업무 자동화), 경영진 보고, 1개월 메시지 질의 지원
- 납품물
- 회차별 강의 자료, 실습 결과물, 경영진 보고 자료
- 기간
- 3회와 1개월 질의 지원
진행 방식
대상 업무와 성공 기준을 정한 뒤 시험판으로 검증하고, 결과를 확인한 범위부터 운영에 적용합니다.
준비해 주실 것
대상 업무 담당자 인터뷰 시간, 개인정보를 제거한 시험 데이터, 연동할 시스템의 접근 권한이 필요합니다.
Contact · 프로젝트 문의
AI 에이전트 프로젝트를 문의해 주십시오.
어느 분야에 맞는지 정하지 못하셨다면 현재 상황과 일정만 적어 보내 주십시오. 검토 후 맞는 범위를 제안드립니다.